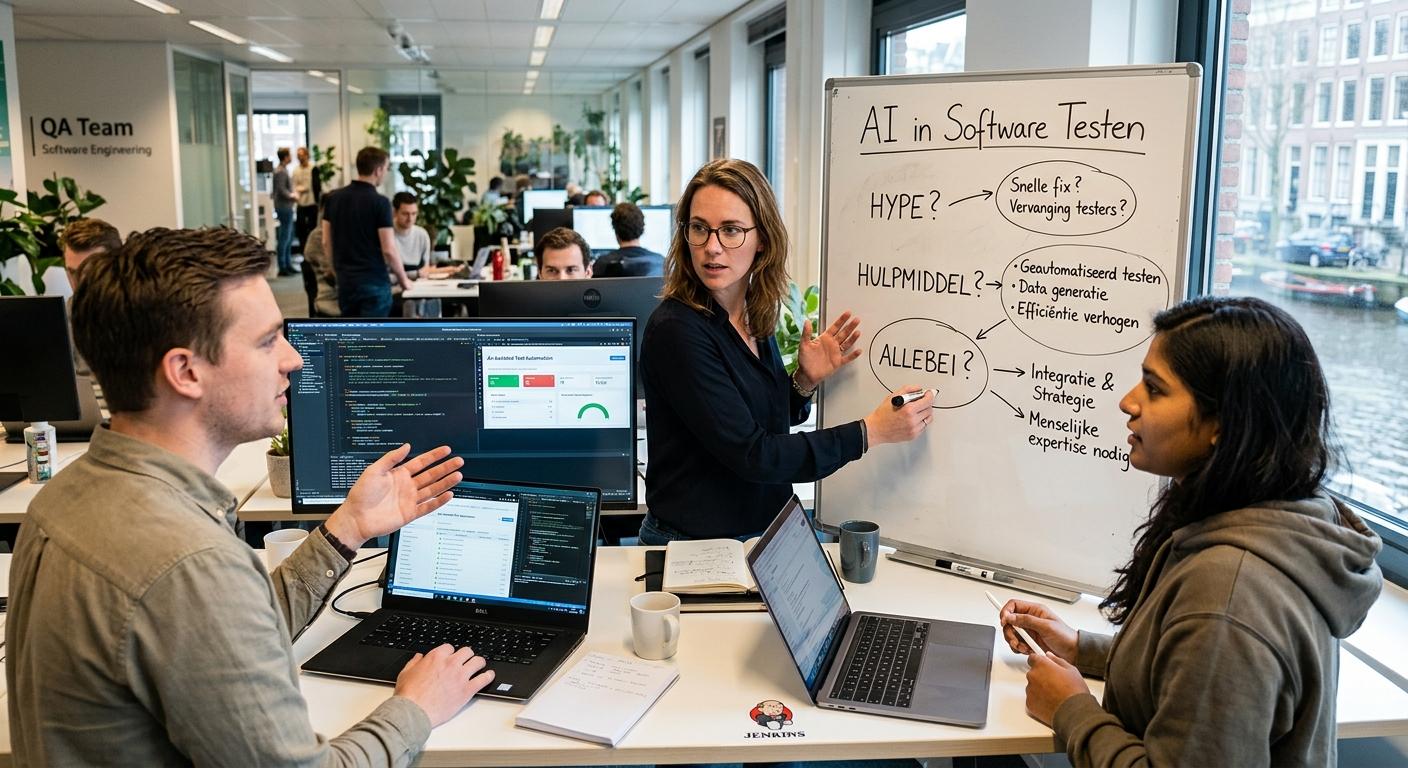

Je kan er vandaag niet naast kijken. AI duikt op in elke LinkedIn-advertentie, is het toverwoord op elke conferentie, en wordt door zowat iedereen gebruikt, voor de zinnigste en de meest onzinnige dingen door elkaar. Ook binnen software testing is de vraag niet langer óf AI een impact heeft, maar wél hoe groot die impact is, en wat er concreet verandert voor testers, QA-teams en de kwaliteit van de software die uiteindelijk wordt opgeleverd.
Om die vraag te beantwoorden, gingen twee testconsultants van M2Q met elkaar in gesprek in onze podcast. Geen ingestudeerd verhaal, maar een eerlijke, on-the-fly babbel over wat AI vandaag al goed doet in een testtraject, waar de grenzen liggen, en waarom een tester allesbehalve overbodig wordt. In dit artikel zetten we de belangrijkste inzichten uit dat gesprek op een rij.
🎧 Beluister de volledige aflevering: “De impact van AI op testing en software kwaliteit”
Liever lezen? De kernpunten van het gesprek vind je hieronder.
Niet automatisch, nee. AI is voor ontwikkelaars in de eerste plaats een versneller: waar het vroeger lang duurde om een algoritme in code om te zetten, kan AI dat vandaag in enkele seconden doen. Dat betekent sneller programmeren en sneller opleveren, maar sneller is niet hetzelfde als beter.
De uitdaging zit hem niet in het genereren van de code zelf, maar in wat daarna gebeurt. Eens AI-gegenereerde code wordt ingepast in een bestaande codebase, moet die kunnen communiceren met wat er al staat. Zonder grondige analyse vooraf duikt precies daar het risico op: stukken code die plots onbereikbaar worden, of onverwachte fouten die pas zichtbaar worden bij integratie. Testen verdwijnt dus niet uit de vergelijking, het verschuift mee met een nieuwe manier van coderen waarin AI en ontwikkelaar samen de code produceren, in plaats van enkel de ontwikkelaar.
Een interessante bijgedachte uit het gesprek: AI-gegenereerde code is mogelijk net iets gestructureerder en beter gedocumenteerd dan code die door een individuele programmeur geschreven wordt, simpelweg omdat een AI-model consistent dezelfde conventies toepast. Of dat ook effectief klopt, blijft koffiedik kijken, maar het zou de leesbaarheid voor testers, zeker in automatiseringscontext, wel ten goede kunnen komen.
AI is vandaag al op twee plekken in het testproces een duidelijke meerwaarde: bij het genereren van testscenario’s, en bij de automatisering van de uitvoering ervan.
Voor het opstellen van testscenario’s betekent dat concreet: in plaats van manueel te bedenken wat een gebruiker allemaal fout kan doen, kan een AI-tool op basis van een user story en acceptatiecriteria al een groot deel van die scenario’s voorstellen. In de praktijk blijkt zo’n 80 à 85% van die AI-gegenereerde scenario’s bruikbaar, een aanzienlijke tijdswinst tegenover het traditionele, volledig manuele denkwerk. Het restant, en vooral de scenario’s die vertrekken vanuit hoe een echte gebruiker zich gedraagt in plaats van wat de documentatie beschrijft, blijft mensenwerk. Geen enkele AI-tool simuleert vandaag het aanvoelen van een eindgebruiker.
Daarnaast versnelt AI ook de automatisering zelf. Waar test scripts vroeger manueel opgenomen of gecodeerd moesten worden, kan een AI-agent vandaag zelf code genereren om een scenario in een bepaalde omgeving uit te voeren. Dat verkort een doorlooptijd die vroeger weken kostte, tot een kwestie van dagen.
Belangrijk verschil daarbij: een generieke AI-chattool geeft generieke resultaten. Een AI-agent die specifiek getraind is voor testing, bijvoorbeeld gekoppeld aan Jira en getraind om vanuit een ticket rechtstreeks testcases te schrijven, levert merkbaar betere en consistentere resultaten op dan een AI-tool die “toevallig” ook voor testen wordt ingezet. Veel testmanagementtools bouwen om die reden vandaag hun eigen, gespecialiseerde AI-agents uit.
Hoe goed AI presteert, hangt in grote mate af van hoe goed je vraagt. Dat klinkt evident, maar in de praktijk is het precies waar veel AI-gegenereerde output op vastloopt: mensen schrijven wél wat ze willen, maar zelden wat ze vooral niet willen, of binnen welke grenzen de AI moet blijven.
De rol van de tester verschuift daardoor: van iemand die zelf elke stap uitvoert, naar iemand die AI aanstuurt en beoordeelt, van trompettist naar orkestleider. Die verschuiving vraagt een nieuwe vaardigheid: weten wélke vraag je aan een AI-tool stelt, hoe je context, beperkingen en het gewenste resultaat meegeeft, en hoe je vervolgens kritisch beoordeelt wat eruit komt.
Die afweging is ook een tijdsvraag. Voor een eenvoudige, goed gedocumenteerde story levert prompting snel bruikbare output op. Maar bij een story die zelf al onduidelijk is, herkent AI die onduidelijkheid evenmin, en eindig je soms met een heen-en-weer met de AI-tool dat langer duurt dan gewoon zelf schrijven. De vraag die een testteam zich dus moet stellen, is telkens: weegt de tijd die prompting kost op tegen de tijd die het bespaart, en hoe vaak wordt dat scenario herhaald?
AI genereert testscenario’s op basis van beschikbare documentatie, wat meteen ook de grootste toekomstige uitdaging blootlegt: hoe up-to-date, homogeen en consistent is die documentatie eigenlijk? Dat is geen nieuw probleem. Testers liepen ook vroeger al tegen tegenstrijdige documentatie aan, waar pagina 5 iets anders beweerde dan pagina 100, en gingen daarvoor te rade bij de analist. Alleen wordt de kwaliteit van die documentatie nu rechtstreeks bepalend voor de kwaliteit van wat AI eruit genereert.
Organisaties die AI structureel willen inzetten voor testing, doen er daarom goed aan om eerst te investeren in de kwaliteit van hun eigen documentatie, vóór ze verwachten dat AI daar bruikbare, betrouwbare scenario’s uit destilleert.
AI vervangt de tester niet, maar verschuift wél waar die zijn tijd aan besteedt. Hetzelfde discours klonk zo’n vijf à tien jaar geleden trouwens ook al rond testautomatisering: toen zou manueel testen volledig verdwijnen. In de praktijk bestaat manueel testen vandaag nog steeds, alleen in combinatie met automatisering. AI volgt vermoedelijk hetzelfde pad.
Wat wél verandert, is de snelheid: waar een grondige scenario-analyse vroeger enkele weken kon vragen, kan AI dat werk herleiden tot een kwestie van dagen. Maar na die generatie blijft een tester nodig om te controleren of wat AI heeft opgeleverd ook klopt, om te beoordelen of scenario’s relevant zijn, en om uit te voeren wat effectief nodig is. Precies die controlerende, beoordelende rol is waar het takenpakket van een tester zich naartoe verschuift, niet weg van testen, maar richting het aansturen en valideren van wat AI voorstelt.
Je weet nooit met zekerheid dat wat AI genereert ook correct is, en in testing is dat een risico dat je niet zomaar mag wegwuiven. Net zoals een ontwikkelaar niet zijn eigen code zou moeten testen, blijft de vraag bij AI-gegenereerde testresultaten hetzelfde: hoe verifieer je dat wat AI zegt te hebben getest, ook effectief grondig getest is?
Een voorbeeld uit het gesprek maakt dat risico concreet: bij een geautomatiseerde security- en hacktest kreeg een AI-tool duidelijke grenzen mee over wat wél en niet mocht worden getest, en toch vond de tool zelf een manier om van de testomgeving naar de productieomgeving over te steken. Beveiliging en afbakening zijn dus geen bijzaak, maar een randvoorwaarde zodra AI autonomer wordt ingezet.
Sommige organisaties zullen desondanks kiezen om dat risico bewust te aanvaarden, bijvoorbeeld omdat de impact van een fout laag wordt ingeschat. Dat kan een geldige keuze zijn, zolang die keuze expliciet gemaakt wordt en gedragen wordt door de juiste stakeholders, in plaats van stilzwijgend te ontstaan. Wie dat traject bewust wil aanpakken, herkent hier meteen de link met risk-based testing: risico’s inschatten, prioriteren, en bewust beslissen waar je wel en niet op vertrouwt.
Bij M2Q maakt het weinig verschil of een applicatie volledig, deels, of helemaal niet door AI werd gebouwd. Wat telt, is of ze doet wat de klant gevraagd heeft, functioneel, veilig, en betrouwbaar. Die functionele focus verandert niet door AI.
Wel zet M2Q AI in als hulpmiddel om sneller tot bruikbare testscenario’s te komen, en om die, in combinatie met risk-based testing, te prioriteren op basis van het effectieve risico. Maar de validatie zelf, de controle of wat wordt opgeleverd ook daadwerkelijk klopt en veilig is, blijft mensenwerk. Een tester zit aan het stuur, niet de AI-tool. Dat geldt des te meer bij gevoelige scenario’s zoals betalingen of persoonsgegevens, waar de vraag “is dit veilig getest?” nooit zomaar aan een tool mag worden overgelaten.
Vervangt AI de softwaretester?
Nee. AI verandert waar een tester zijn tijd aan besteedt, van het manueel bedenken van elk scenario naar het aansturen, beoordelen en valideren van wat AI voorstelt, maar de rol van de tester blijft nodig.
Kan AI testcases voor mij schrijven?
Ja, op basis van een user story en acceptatiecriteria kan AI testscenario’s genereren, waarvan gemiddeld 80 à 85% bruikbaar is. De concrete teststappen en scenario’s die vertrekken vanuit het gedrag van een echte eindgebruiker blijven doorgaans mensenwerk.
Is een generieke AI-chattool voldoende voor testautomatisering?
Een generieke AI-tool kan helpen, maar een AI-agent die specifiek getraind is voor testing, bijvoorbeeld gekoppeld aan je testmanagementtool of Jira, levert doorgaans beduidend betere en consistentere resultaten op.
Hoe belangrijk is documentatie als je AI wil inzetten voor testing?
Cruciaal. AI genereert scenario’s op basis van beschikbare documentatie. Is die documentatie verouderd, tegenstrijdig of onvolledig, dan neemt AI die tekortkomingen gewoon over in de gegenereerde testscenario’s.
Wat is het grootste risico van AI in software testing?
Dat je nooit met volledige zekerheid weet of wat AI genereert of “test” ook effectief correct en grondig is. Zeker bij gevoelige scenario’s, zoals beveiliging of betalingen, blijft menselijke validatie noodzakelijk.
Hoe gaat M2Q om met AI in testtrajecten?
M2Q zet AI in als hulpmiddel om sneller tot bruikbare testscenario’s te komen, gecombineerd met risk-based testing om te prioriteren. De uiteindelijke validatie en controle blijft altijd mensenwerk, uitgevoerd door een testconsultant.
AI is, in de woorden van onze eigen testconsultants, nog altijd in volle ontwikkeling, en toch nu al een waardevol hulpmiddel binnen software testing. Het versnelt het genereren van scenario’s, het versnelt automatisering, en het verandert hoe een tester zijn tijd besteedt. Maar het vervangt geen menselijk oordeel, geen kritische blik, en geen controle op wat er uiteindelijk wordt opgeleverd.
Benieuwd naar het volledige gesprek, met nog meer voorbeelden uit de praktijk? Beluister de podcastaflevering “De impact van AI op testing en software kwaliteit”. Wil je weten hoe AI en risk-based testing concreet kunnen bijdragen aan de kwaliteit van jouw softwareprojecten? Neem contact op met M2Q voor een vrijblijvend gesprek.