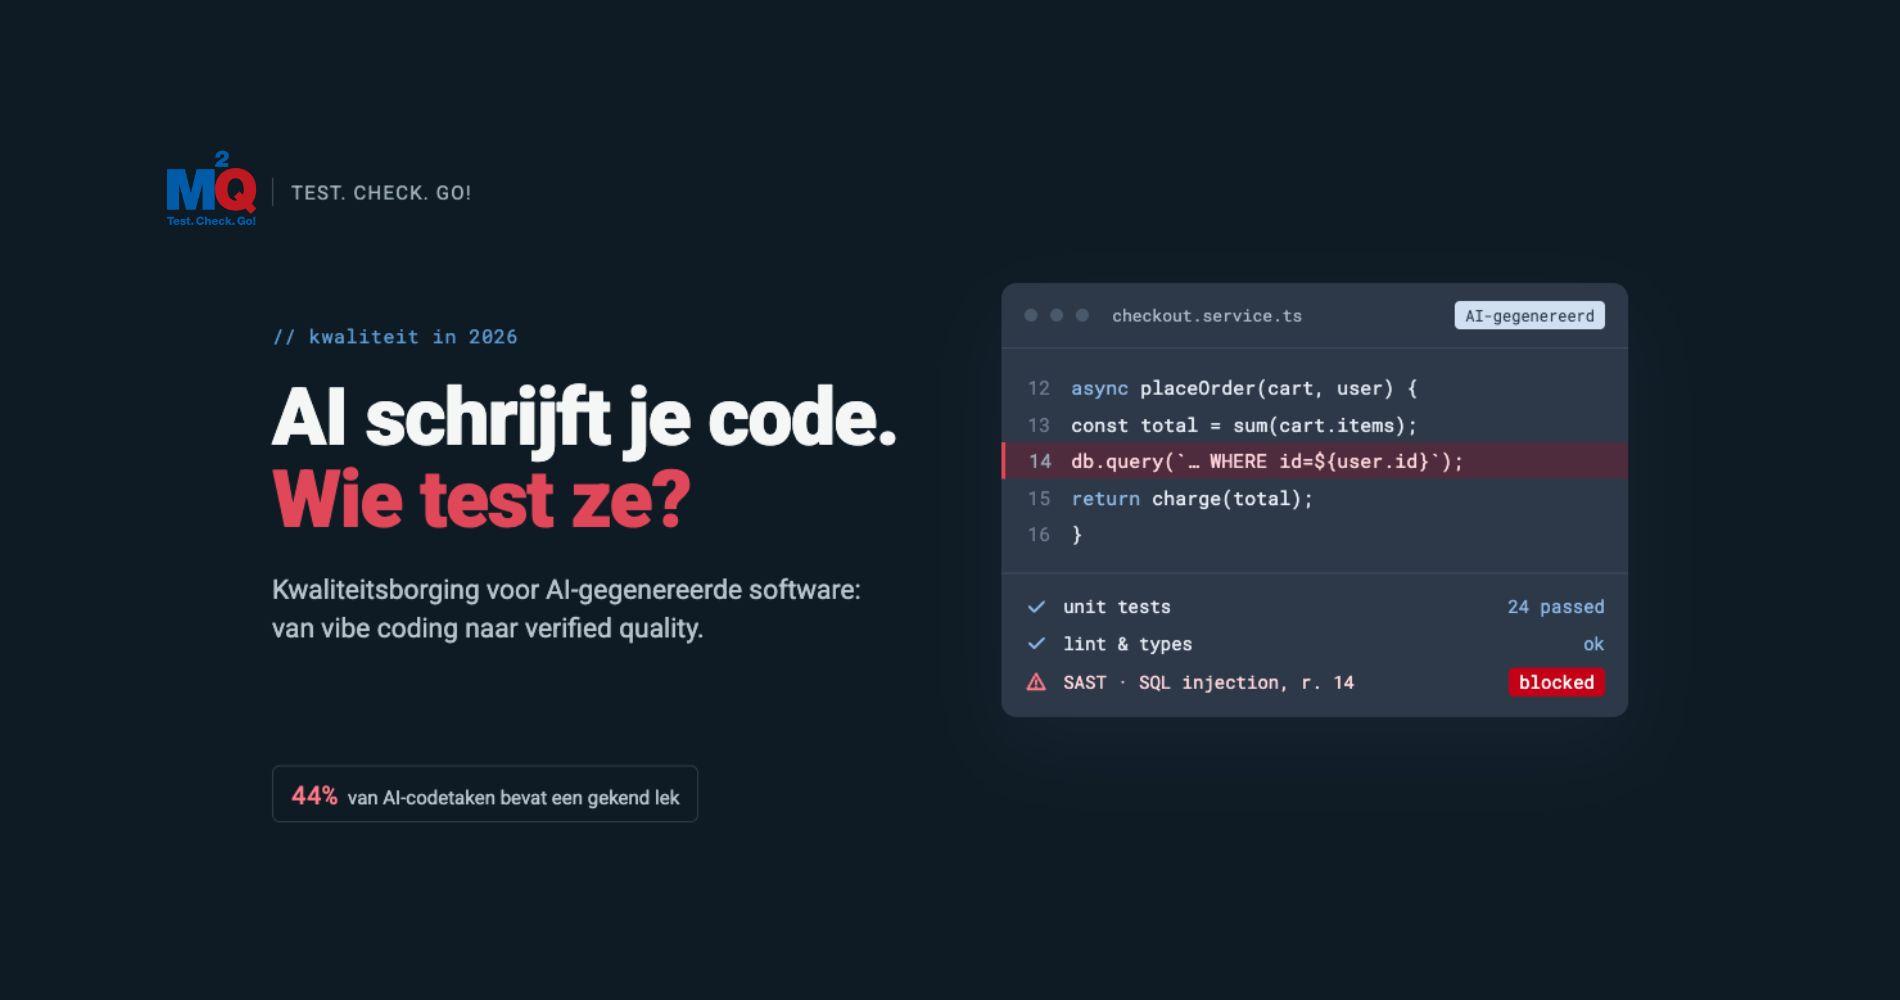
Behandel AI-code als code van een onbekende externe leverancier: snel en vaak bruikbaar, maar nooit blind te vertrouwen. Combineer vier lagen: duidelijke specificaties vooraf, geautomatiseerde quality gates in je CI/CD-pipeline (unit tests, statische analyse, security scanning), verplichte menselijke review op risicovolle wijzigingen, en monitoring in productie. AI-testagents kunnen het uitvoerende werk overnemen, maar mensen blijven eigenaar van de kwaliteitsdoelen en de eindbeslissing.
Twee jaar geleden was de vraag of developers AI-assistenten zouden gebruiken. Vandaag is die vraag beantwoord. Volgens Google Clouds DORA-onderzoek gebruikt ongeveer 90% van de technologieprofessionals AI in zijn dagelijkse werk. Codeassistenten en autonome codeeragents schrijven functies, tests, migraties en soms volledige applicaties.
Dat klinkt als goed nieuws, en voor een deel is het dat ook. Teams leveren sneller. Prototypes staan er in uren in plaats van weken. Maar wie dagelijks software test, ziet de keerzijde. Er komt meer code binnen dan ooit, die er overtuigend uitziet, compileert en vaak zelfs de happy path doorloopt. Of ze ook veilig, onderhoudbaar en correct is in randgevallen, is een andere zaak.
De bottleneck in softwareontwikkeling is daardoor verschoven. Het probleem is niet langer hoe snel we code kunnen schrijven. Het probleem is hoe snel we kunnen vaststellen dat die code te vertrouwen is. Dat is precies het domein van softwaretesten en kwaliteitsborging.
In deze blog bekijken we bij m2q waarom het testen van AI-gegenereerde code hét kwaliteitsthema van 2026 is. We zetten de belangrijkste cijfers op een rij, leggen uit waar klassieke testaanpakken tekortschieten, bespreken de opkomst van agentic testing en de nieuwe Europese meldplicht, en eindigen met een concreet stappenplan dat je morgen kunt toepassen.
AI-gegenereerde code is broncode die geheel of gedeeltelijk geschreven is door een large language model (LLM), via een codeassistent in de IDE, een chatinterface of een autonome codeeragent die zelfstandig taken uitvoert in een repository.
Vibe coding is de praktijk waarbij een ontwikkelaar in natuurlijke taal beschrijft wat hij wil en de AI de implementatie laat schrijven, vaak zonder de gegenereerde code regel per regel te lezen of expliciete eisen rond beveiliging en kwaliteit mee te geven. Het werkt opvallend goed voor prototypes en interne tools. Voor productiesoftware is het een risico, omdat de verantwoordelijkheid voor correctheid ongemerkt verschuift naar een model dat geen verantwoordelijkheid kan dragen.
Drie eigenschappen maken AI-code anders dan menselijke code, ook al ziet ze er hetzelfde uit:
De belangrijkste onderzoeken van het afgelopen jaar wijzen allemaal dezelfde kant uit: AI versnelt, maar de kwaliteitsborging houdt het tempo niet bij.
| Bron | Kernbevinding | Wat het betekent voor testen |
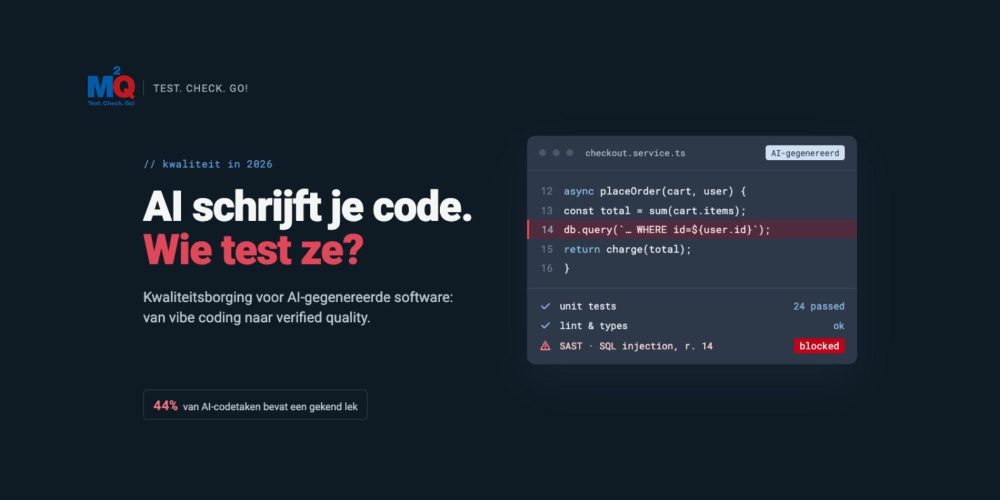
| Veracode 2026 GenAI Code Security Report (aug. 2026) | Ongeveer 44% van de geteste AI-codetaken introduceerde een gekend lek; gemiddelde security pass rate 56%, nauwelijks beter dan 55% een jaar eerder | Nieuwere modellen lossen het securityprobleem niet vanzelf op; security testing moet in de pipeline |
| Veracode 2025, per taal | Security pass rate: Python 62%, JavaScript 57%, C# 55%, Java 29% | Het risico verschilt per stack; stem je testdiepte daarop af |
| DORA 2025, State of AI-assisted Software Development | AI verhoogt de doorvoer, maar hangt samen met meer instabiliteit; slechts een kleine minderheid heeft veel vertrouwen in AI-output | Snelheid zonder vangnet leidt tot meer change failures en rework |
| World Quality Report 2025-26 | 89% piloot of gebruikt GenAI in quality engineering, maar slechts 15% heeft het bedrijfsbreed opgeschaald; gemiddelde productiviteitswinst 19% | De kloof zit in governance, vaardigheden en integratie, niet in de technologie |
| Tricentis, QA-trends 2026 | Minstens 60% van AI-gegenereerde code bevat problemen die ingrijpen vereisen | Menselijke review blijft nodig, maar moet slimmer worden ingezet |
Het meest bruikbare inzicht komt uit het DORA-onderzoek van Google Cloud. AI werkt als een versterker van wat er al is. Teams met sterke fundamenten (goede tests, kleine batches, snelle feedback, heldere processen) halen er echt winst uit. Teams met zwakke fundamenten produceren vooral sneller problemen.
Het vervolgrapport van DORA over de ROI van AI-ondersteunde ontwikkeling uit 2026 trekt die lijn door: de return van AI hangt af van de vraag of de rest van de delivery-flow het tempo kan volgen. Code review en testen zijn daarbij de plekken waar die winst gemaakt of verloren wordt.
Voor kwaliteitsprofessionals is dat een belangrijke boodschap. Testen is niet langer de rem op AI-adoptie. Het is de voorwaarde om er rendement uit te halen.
Veel organisaties proberen AI-code te testen met dezelfde aanpak als vijf jaar geleden. Dat loopt op vier punten vast.
Code review was altijd een belangrijke kwaliteitspoort. Als een agent tien keer meer pull requests aanmaakt, wordt reviewen een lopende band. Onderzoek dat in het Veracode-rapport wordt aangehaald, suggereert dat minder dan de helft van de developers AI-code reviewt voor ze die commit. Reviewmoeheid is geen karakterfout; het is een capaciteitsprobleem dat je met proces en automatisering moet oplossen.
Een veelvoorkomend patroon: de AI schrijft de code én de unit tests. Die tests slagen, de coverage stijgt, en iedereen is tevreden. Maar tests die door hetzelfde model en vanuit dezelfde aannames zijn geschreven, bevestigen vaak gewoon wat de code doet, niet wat ze zou moeten doen. Je meet dan consistentie, geen correctheid.
Codecoverage was altijd al een zwakke indicator. Met AI-gegenereerde tests wordt het bijna misleidend. Hoge coverage met zwakke assertions geeft een vals gevoel van veiligheid. Mutation testing, property-based testing en risicogebaseerde testdekking worden daarom belangrijker.
AI-code is vaak functioneel in orde voor het scenario dat in de prompt stond. Beveiliging, performantie, toegankelijkheid, logging en foutafhandeling zijn veel vaker zwakke plekken, zeker als niemand ze expliciet heeft gevraagd. Dat zijn precies de domeinen waar klassieke functionele regressietests weinig vangen.
De conclusie: de teststrategie moet verschuiven van het controleren van output naar het borgen van het hele proces waarmee code ontstaat, wordt gevalideerd en in productie wordt gevolgd.
Waar AI de ontwikkelkant versnelt, komt er ook aan de testkant een nieuwe generatie tools: agentic testing. Dat zijn AI-agents die niet alleen een script uitvoeren, maar zelfstandig doelen nastreven. Ze lezen user stories en requirements, stellen testgevallen op, genereren en onderhouden automatisatiescripts, voeren die uit, analyseren resultaten en loggen defecten.
Toonaangevende spelers als Parasoft, Tricentis en Xray zetten autonome testagents bovenaan hun trendlijsten voor 2026. De verwachting is dat veel organisaties dit jaar de stap zetten van experiment naar echte implementatie.
Daarom spreken steeds meer experts niet over quality engineering maar over trust engineering: niet alleen de applicatie testen, maar ook de agents die het werk doen evalueren.
Voor Belgische en Europese bedrijven komt er een extra dimensie bij. Sinds 11 september 2026 gelden de meldplichten van de Cyber Resilience Act (CRA), Verordening (EU) 2024/2847. Fabrikanten van producten met digitale elementen, zowel hardware als software, moeten actief uitgebuite kwetsbaarheden en ernstige beveiligingsincidenten melden via het Single Reporting Platform van ENISA.
De termijnen zijn kort:
| Stap | Termijn |
| Vroege waarschuwing | Binnen 24 uur na kennisname |
| Volledige melding | Binnen 72 uur |
| Eindrapport kwetsbaarheid | Uiterlijk 14 dagen nadat een correctie beschikbaar is |
| Eindrapport ernstig incident | Binnen een maand na de 72-uursmelding |
De overige CRA-verplichtingen, zoals secure by design, geen gekende uitbuitbare kwetsbaarheden bij levering en een gestructureerd proces voor kwetsbaarheidsbeheer, gelden vanaf 11 december 2027. Volgens advocatenkantoor Freshfields gelden de meldplichten ook voor producten die al vóór de volledige toepassing van de CRA op de markt waren.
De link met AI-code is direct. Als bijna de helft van de AI-codetaken een gekend lek introduceert, en een steeds groter deel van je codebase door AI wordt geschreven, dan groeit je blootstelling mee. Een kwetsbaarheid die je niet in je pipeline vindt, kan vandaag een meldplichtig incident met een 24-uursdeadline worden.
Voor organisaties die software bouwen of integreren, betekent dit dat security testing, kwetsbaarheidsbeheer en traceerbaarheid geen nice-to-have meer zijn. Je moet kunnen aantonen welke code waar vandaan komt, hoe ze getest is en hoe je snel kunt detecteren en reageren. Dit is geen juridisch advies; laat de toepasselijkheid voor jouw producten bevestigen door een jurist.
Hoe pak je het testen van AI-gegenereerde code concreet aan? Dit is het raamwerk dat we bij m2q hanteren in onze assessments en begeleidingstrajecten.
Je kunt niet borgen wat je niet ziet. Inventariseer welke teams welke AI-tools gebruiken, voor welke taken en met welke rechten. Maak AI-herkomst zichtbaar, bijvoorbeeld via commit-labels of PR-templates. Zo kun je later analyseren of incidenten vaker voorkomen in AI-geschreven code.
De kwaliteit van AI-output hangt sterk af van de kwaliteit van de input. Duidelijke acceptatiecriteria, voorbeelden (bijvoorbeeld in Gherkin) en expliciete niet-functionele eisen rond security, performantie en toegankelijkheid zijn het beste preventieve testinstrument dat er is. Dit is shift-left in zijn puurste vorm.
Laat tests niet uitsluitend genereren door dezelfde AI-sessie die de code schreef. Schrijf kritieke tests eerst (test-first), laat ze door een tester of een andere agent opstellen vanuit de specificatie, of laat een mens de testintentie reviewen. Het doel is onafhankelijkheid, een oud testprincipe dat nu weer actueel wordt.
Elke wijziging, AI of niet, passeert dezelfde poorten: statische analyse, SAST en dependency scanning, unit- en integratietests, en voor kritieke componenten mutation testing. Maak deze gates blokkerend, niet adviserend. Houd pull requests klein; het DORA-onderzoek toont dat kleine batches het positieve effect van AI versterken.
Niet elke wijziging verdient dezelfde aandacht. Classificeer code naar risico: authenticatie, betalingen, persoonsgegevens en kernbusinesslogica krijgen verplicht een grondige menselijke review. Een CSS-aanpassing in een intern dashboard niet. Zo zet je schaarse reviewcapaciteit in waar ze het meeste oplevert.
Behandel AI-testtools als elk ander systeem dat je test. Leg een baseline vast met bekende defecten en meet of de agent ze vindt. Volg het aantal false positives en false negatives. Laat beslissingen met impact, zoals het als opgelost markeren van een bug of het aanpassen van een assertion, altijd door een mens bevestigen.
Geen enkele teststrategie vangt alles. Observability, feature flags, canary releases en goede monitoring maken van productie een extra testsignaal. Meet naast doorvoer ook change failure rate en rework rate. Koppel incidenten terug naar je testsuite zodat elke fout in productie een nieuwe regressietest oplevert. Met de CRA-meldplicht is snelle detectie bovendien een wettelijke noodzaak.
Gebruik deze tabel als vertrekpunt voor je eigen Definition of Done.
| Quality gate | Wat je controleert | Wanneer | Blokkerend? |
| Specificatiecheck | Acceptatiecriteria en niet-functionele eisen aanwezig vóór generatie | Refinement | Ja |
| Statische analyse en linting | Codeconventies, complexiteit, code smells | Elke commit | Ja |
| SAST en secret scanning | OWASP Top 10, hardcoded credentials, injectie | Elke commit | Ja |
| Dependency- en SBOM-scan | Kwetsbare of verzonnen packages, licenties | Elke build | Ja |
| Unit- en integratietests | Functioneel gedrag, contracten tussen services | Elke PR | Ja |
| Mutation testing | Kwaliteit van de tests zelf | Kritieke modules, nightly | Op drempel |
| Risicogebaseerde review | Logica, security, privacy | Hoogrisico-PR’s | Ja |
| E2E- en performantietests | Gebruikersflows, last, regressies | Voor release | Ja |
| Productiemonitoring | Fouten, latency, change failure rate | Continu | Alarmering |
Een aandachtspunt bij de dependency-scan: AI-modellen verzinnen soms packagenamen die niet bestaan. Kwaadwillenden registreren zulke namen soms om malware te verspreiden. Controleer daarom niet alleen op gekende kwetsbaarheden, maar ook of elke dependency bestaat en betrouwbaar is.
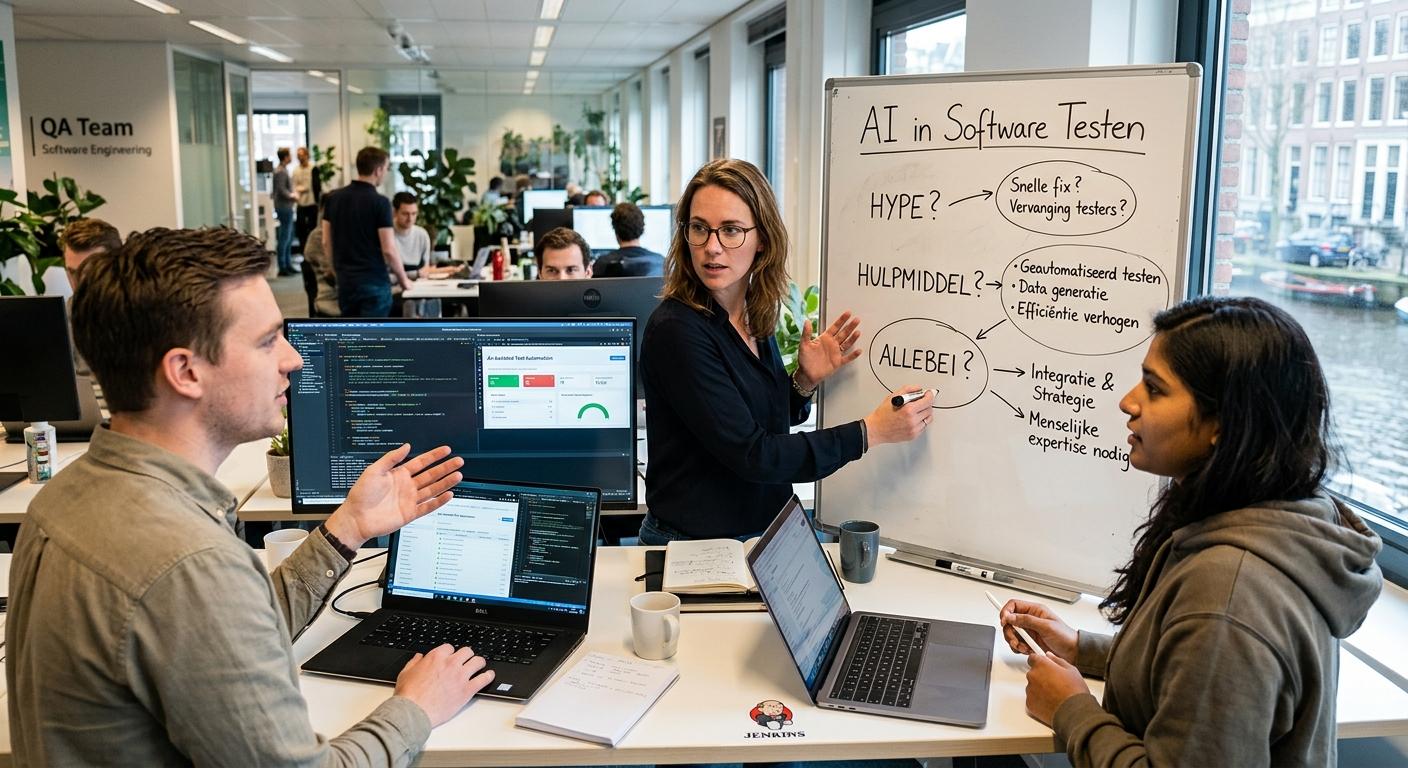
Verdwijnt de tester door AI? Alle signalen wijzen de andere kant op. De rol verandert wel grondig.
Waar testers vroeger vooral scripts schreven en uitvoerden, definiëren ze nu kwaliteitsdoelen, houden ze toezicht op AI-resultaten en bewaken ze dat geautomatiseerde beslissingen aansluiten bij de bedrijfsprioriteiten. Tricentis beschrijft QA-leiders als orkestratoren. Accenture spreekt over trust engineers.
Het World Quality Report bevestigt die verschuiving in de gevraagde vaardigheden. Generatieve AI staat bovenaan (63%), maar kernvaardigheden in quality engineering volgen vlak daarna (60%), samen met programmeervaardigheden (58%) en domeinkennis (56%). Tegelijk geeft de helft van de organisaties aan dat AI/ML-expertise ontbreekt, en heeft slechts 53% van de testers een AI-opleiding gekregen.
De tester van 2026 combineert dus drie dingen:
Organisaties die nu investeren in deze profielen, bouwen een concurrentievoordeel op. Wie testers vervangt door alleen tools, ruilt zichtbare kosten in voor onzichtbare risico’s.
In gecontroleerde tests van Veracode introduceerde ongeveer 44% van de AI-codetaken een gekend beveiligingslek wanneer er geen expliciete security-instructie werd meegegeven. De score verbetert nauwelijks met nieuwere modellen. Daarom moet AI-code altijd door geautomatiseerde security testing en, bij risicovolle onderdelen, door menselijke review.
Als aanvulling wel, als enige vangnet niet. Tests die door hetzelfde model worden geschreven, delen vaak dezelfde aannames als de code. Combineer AI-gegenereerde tests met tests die vanuit de specificatie zijn opgesteld, met mutation testing en met menselijke review van de testintentie.
Agentic testing is een vorm van testautomatisering waarbij AI-agents zelfstandig doelen nastreven: ze analyseren requirements, genereren en onderhouden tests, voeren ze uit, interpreteren resultaten en registreren defecten. Mensen bepalen de kwaliteitsdoelen en valideren de beslissingen van de agent.
Nee. De rol verschuift van uitvoeren naar ontwerpen, sturen en valideren. Volgens het World Quality Report 2025-26 blijven kernvaardigheden in quality engineering bijna even belangrijk als GenAI-kennis.
Sinds 11 september 2026 moeten fabrikanten van producten met digitale elementen actief uitgebuite kwetsbaarheden binnen 24 uur melden bij ENISA. Vanaf december 2027 mogen producten bovendien niet met gekende uitbuitbare kwetsbaarheden op de markt komen. Systematisch security testing en kwetsbaarheidsbeheer worden daarmee een wettelijke vereiste.
Begin met een nulmeting: waar gebruikt je organisatie AI, welke quality gates bestaan er al en waar zitten de gaten? Een testassessment geeft je in enkele weken een objectief beeld en een geprioriteerd verbeterplan.
AI heeft het schrijven van code goedkoop en snel gemaakt. Het vaststellen dat die code betrouwbaar, veilig en onderhoudbaar is, blijft echter werk. Dat werk wordt belangrijker naarmate er meer AI-code in productie belandt en de Europese regelgeving strenger wordt.
De organisaties die in 2026 het meeste uit AI halen, zijn niet die met de meeste AI-tools. Het zijn de organisaties met de sterkste kwaliteitsfundamenten: heldere specificaties, blokkerende quality gates, risicogebaseerde review, gevalideerde testagents en een korte feedbacklus vanuit productie.
Bij m2q helpen we organisaties in België en daarbuiten om software met vertrouwen op te leveren, ook als een groeiend deel ervan door AI wordt geschreven. Concreet bieden we:
Wil je weten waar de gaten zitten in jouw kwaliteitsaanpak? Neem contact op met m2q voor een vrijblijvend gesprek over een testassessment.